Auto Ontology : le sens de tes données pour tes agents IA
Auto Ontology, bibliothèque libre de NVIDIA, construit un dictionnaire métier validé par des humains pour que tes agents IA répondent avec la requête SQL et les étapes. Essai local par Docker Compose.
Sommaire
Tu poses une question simple à un agent IA : « Quel a été le chiffre d'affaires de tel produit dans tel État en juin ? » Il répond vite, avec aplomb. Mais est-ce le bon chiffre ? Si l'agent a mal compris ce que « chiffre d'affaires » veut dire dans ta base, la réponse rapide ne vaut rien.
C'est le problème que NVIDIA attaque avec Auto Ontology, une bibliothèque libre qui construit une couche de sens entre tes données et tes agents IA. Elle apprend à l'agent où vivent les données, ce qu'elles signifient, et d'où vient chaque réponse.
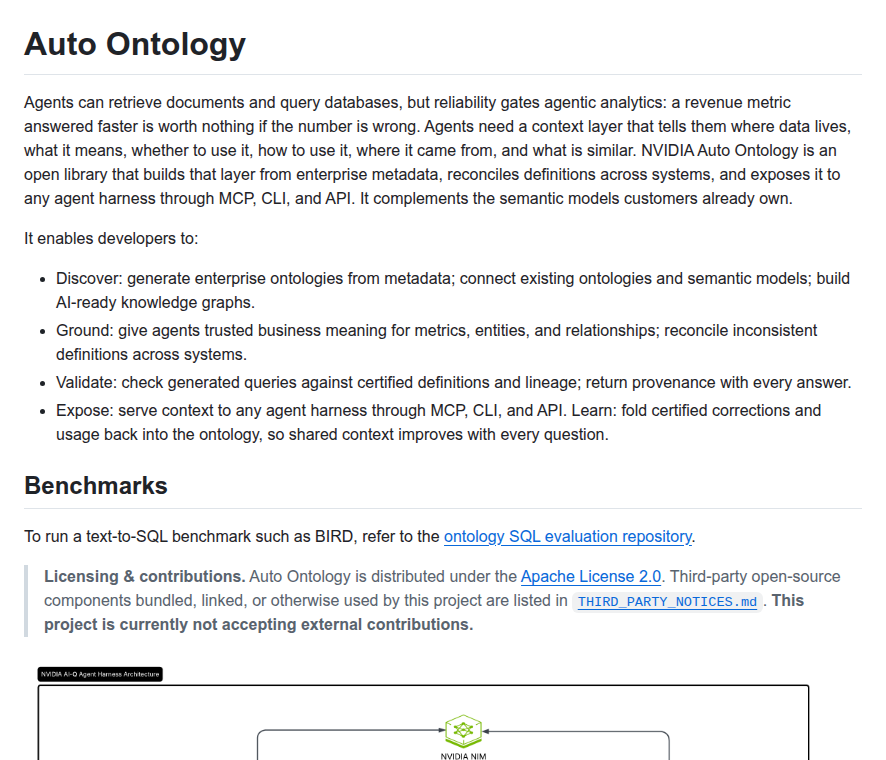
Une « ontologie » est un mot compliqué pour une idée simple : un dictionnaire d'entreprise. Il dit que « Client » correspond à telles colonnes, que « Ligne de facture » sert à calculer le chiffre d'affaires, et comment les tables se relient entre elles.
Pourquoi c'est utile
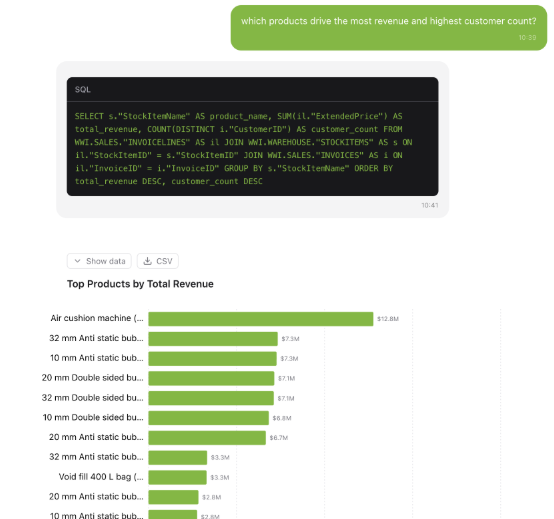
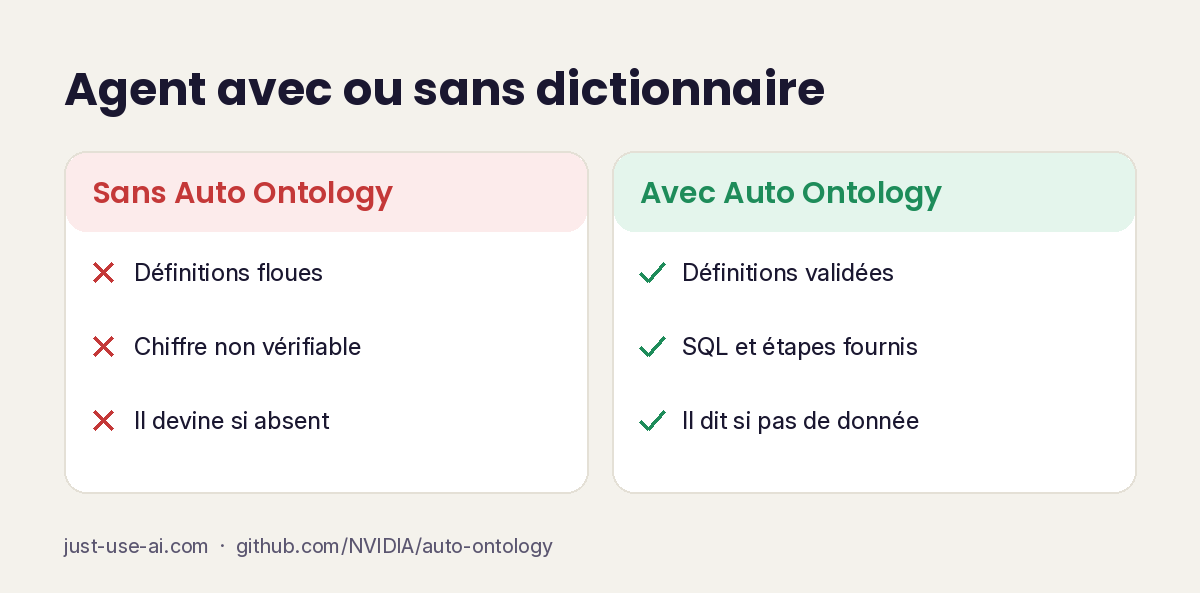
- Des réponses vérifiables. Chaque réponse arrive avec la requête SQL utilisée et les étapes suivies. Ton équipe peut contrôler le résultat à la source.
- Un calcul identique pour tous. Une mesure comme la marge est écrite une fois, relue par une personne, puis réutilisée par l'agent.
- Un agent qui sait dire « je ne sais pas ». Si ta base ne contient pas la donnée demandée, l'outil le signale au lieu d'inventer.
- Pas de rupture avec l'existant. L'outil complète les modèles sémantiques que tu as déjà, il ne les remplace pas.
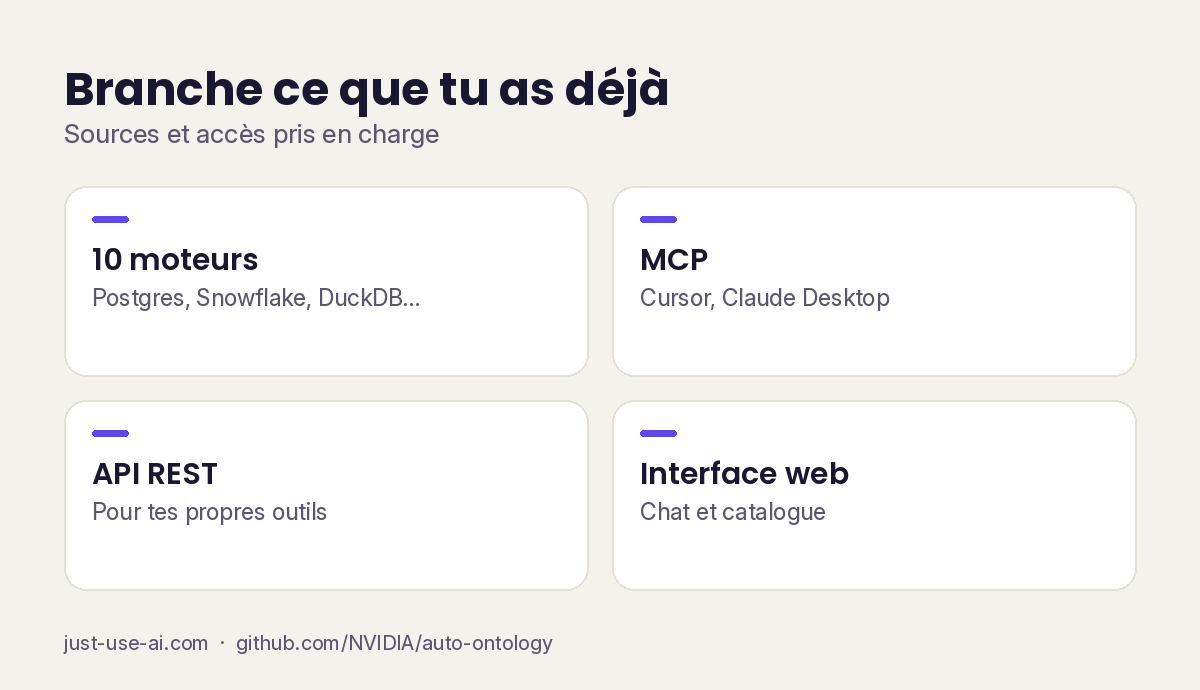
- Branchable sur tes outils. Un protocole standard (MCP), une API et une interface web permettent de l'utiliser depuis Cursor, Claude Desktop ou ton propre code.
Comment il construit ce dictionnaire
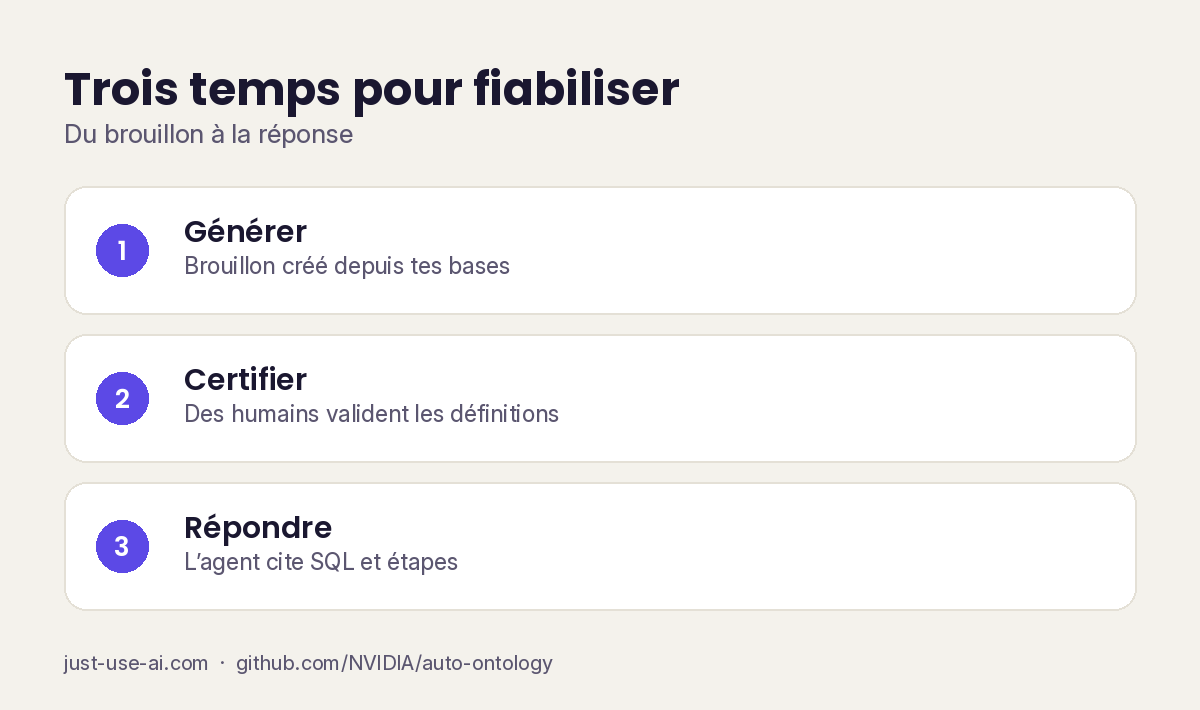
Auto Ontology travaille en trois temps : il génère un brouillon, des humains le valident, puis l'agent répond à partir de ce dictionnaire validé.
Pour le brouillon, le service lit les schémas de tes bases, observe les colonnes et des exemples de valeurs, puis repère les concepts métier table par table. Il déduit aussi comment les tables se joignent, y compris via des tables intermédiaires, et propose des calculs réutilisables à partir de l'historique de requêtes. Le tout est stocké dans une base Postgres.
Le dictionnaire contient trois sortes d'éléments : des termes (les concepts métier, avec description et synonymes), des attributs SQL (des calculs relus, comme une marge) et des relations (comment les tables se joignent).
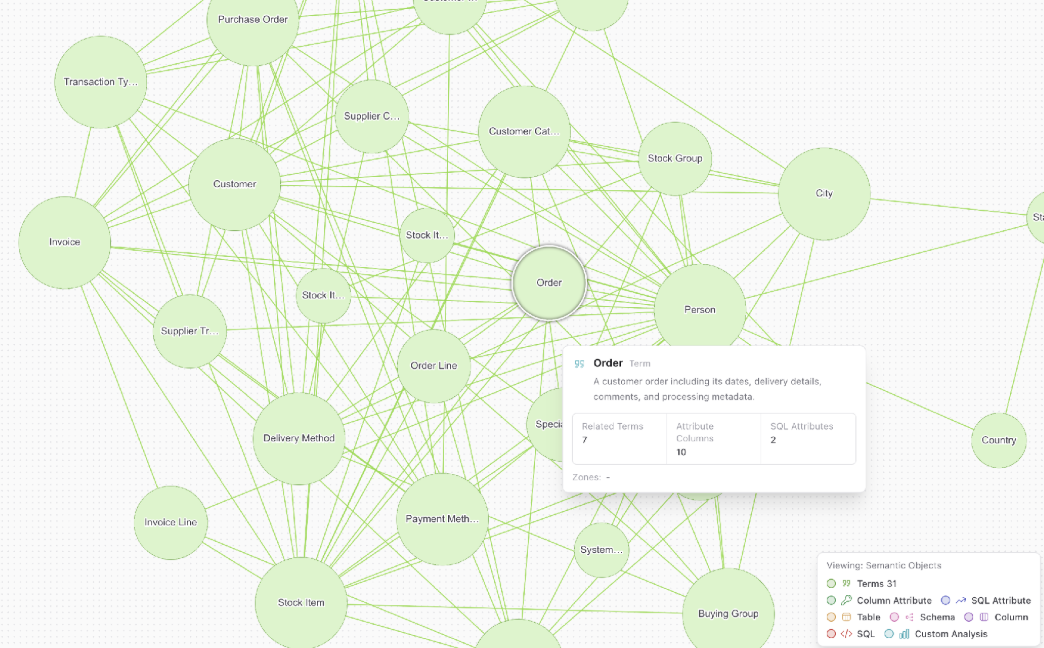
Sur la base d'exemple du README (une base de ventes de Microsoft), une compilation a produit 31 termes. L'interface permet de les explorer sous forme de graphe : tu cliques sur « Order » et tu vois sa description, les termes voisins, les colonnes associées et les calculs attachés.
Ce qui se passe quand tu poses une question
L'agent commence par comprendre l'intention de la question et repérer les éléments qu'elle nomme. Il cherche ensuite, dans le dictionnaire, les termes, colonnes et calculs les plus proches. Il écrit la requête SQL à partir de ces candidats, vérifie les valeurs de filtre et la requête contre la base, la corrige si un contrôle échoue, puis l'exécute.
Le README donne un exemple parlant : une question sur le chiffre d'affaires d'un produit dans un État pour un mois donné. L'agent identifie le « chiffre d'affaires », le « produit » et l'« État », suit les liens entre les tables pour trouver les jointures, et renvoie la réponse avec la requête et les étapes.
Dans le chat, tu peux aussi afficher les lignes, les télécharger en CSV ou les lire sous forme de graphique.
Le second exemple du README est peut-être le plus intéressant pour une entreprise. On demande le retour sur dépenses publicitaires, alors que la base n'a aucune donnée publicitaire. L'agent connecté vérifie d'abord si la question est couverte, constate qu'aucun terme ne correspond, et demande s'il doit plutôt sortir le chiffre d'affaires ou connecter une autre source. Un agent qui refuse de deviner, c'est précisément ce qu'on attend d'un outil qui touche à des chiffres.
Ce que ça change pour une équipe ou une PME
Dans beaucoup d'équipes, chaque service a sa propre définition d'un « client actif » ou d'une « marge ». Les agents IA héritent de ce flou et le propagent plus vite. Auto Ontology donne un endroit où ces définitions sont écrites, discutées, validées, puis servies de la même façon à tous les agents.
Le README cite dix moteurs de données pris en charge : PostgreSQL, MySQL, Databricks, Snowflake, ClickHouse, Trino, Apache Kyuubi, HeavyDB, DuckDB et SQLite. Tu peux brancher ce que tu as déjà. L'outil s'installe avec Docker Compose pour un essai local, ou avec un chart Helm pour Kubernetes.
L'outil est compatible avec Apache Ossie, un standard ouvert d'échange de modèles sémantiques. Tu peux donc importer et exporter tes définitions au lieu de les enfermer dans un outil.
À savoir avant de te lancer
L'outil est sérieux, mais il n'est pas léger. Voilà ce qu'il faut regarder de près.
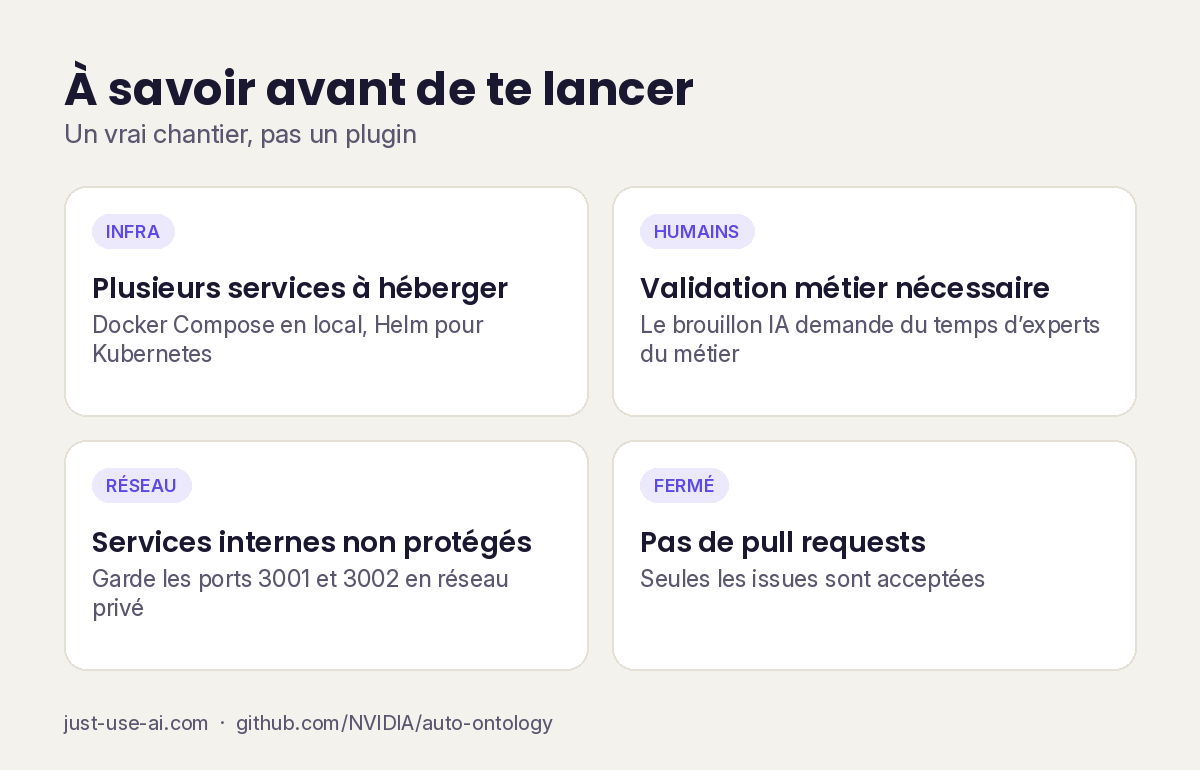
- Il demande de l'infrastructure. Le démarrage rapide fait tourner plusieurs services (interface, serveur, ingestion, base Postgres avec recherche vectorielle). C'est plus un chantier technique qu'une extension à installer en cinq minutes.
- Il faut des humains pour valider. Le brouillon est généré par des modèles IA. La confiance vient de l'étape de certification, qui demande du temps de personnes qui connaissent ton métier.
- Les modèles par défaut sont ceux de NVIDIA. Il faut une clé d'API NVIDIA, ou un point d'accès compatible que tu configures toi-même, y compris auto-hébergé.
- La sécurité réseau est à ta charge. Le README précise que deux des services internes ne s'authentifient pas eux-mêmes : ils doivent rester sur un réseau privé, et les utilisateurs passent par l'application web.
- Les prédictions envoient des données ailleurs. Si tu actives le service KumoRFM, l'agent lui transmet les tables connectées. Le README demande de faire valider cela par l'organisation avant d'activer l'option.
- Pas de contributions externes. L'équipe NVIDIA maintient le code et n'accepte pas de pull requests. Les demandes d'intégration et les rapports de bugs passent par les issues.
Pour qui c'est
- Équipes data et BI qui voient leurs agents donner des chiffres différents d'un jour à l'autre : le dictionnaire commun et la validation règlent ce point à la racine.
- Responsables techniques de PME qui veulent ouvrir leurs bases à des questions en langage naturel sans perdre le contrôle sur la définition des indicateurs.
- Développeurs d'agents qui cherchent une source de contexte fiable à brancher via MCP ou via l'API.
- Dirigeants qui veulent savoir d'où vient un chiffre avant de le présenter : la requête et les étapes accompagnent chaque réponse.
Bottom line
Auto Ontology ne rend pas ton agent plus bavard, il le rend plus vérifiable. Il réclame un vrai chantier d'installation et du temps de validation métier, mais c'est le prix d'un agent dont tu peux justifier les chiffres. Le dépôt est ici : github.com/NVIDIA/auto-ontology, avec le démarrage rapide sur une base d'exemple pour tout tester en local avant d'y brancher tes vraies données. La licence est Apache-2.0.
Accède aux ressources gratuites
Vidéos, guides, templates et outils pour automatiser ton quotidien avec l'IA. Laisse ton email — accès immédiat, à vie.
✓ Pas de spam · ✓ Accès gratuit à vie · ✓ Désinscription en 1 clic
On utilise ton email pour t'envoyer la ressource et nos guides IA. Tu peux te désinscrire à tout moment. Voir notre politique de confidentialité.